STK1110 · UiO
Studieguide for STK1110 Statistiske metoder og dataanalyse
Komplett pensumoversikt for statistiske metoder og dataanalyse ved UiO — med forklaringer, sentrale begreper, eksamenstips og vanlige fallgruver. Eksamensoptimalisert basert på tidligere eksamener.
Introduksjon
STK1110 Statistiske metoder og dataanalyse avsluttes med en skriftlig eksamen i desember: 4 timer, godkjent kalkulator og Formelsamling for STK1110 (H2022–H2025). Denne guiden er bygd på alle 22 eksamenssett fra H2004 til H2025 og UiOs løsningsforslag for H2007–H2025, og alle frekvenser under er talt i settene.
Eksamen har hatt samme skjelett i 9 av 9 sett siden 2017:
- Estimering — en tetthet er oppgitt, og du skal finne momentestimator, sannsynlighetsmaksimeringsestimator (MLE), Fisher-informasjon og den tilnærmede fordelingen til MLE, ofte med et konfidensintervall eller en sammenligning av estimatorer til slutt. H2022 og H2025 avsluttet med en bayesiansk analyse.
- Regresjon med R-utskrift — du får
summary(lm(...))og residualplott, skal tolke estimatene, lage konfidensintervall for , vurdere modellantakelsene og forklare hva som skjer når en ny forklaringsvariabel eller et kvadratisk ledd tas med. - Konfidensintervall og test for én forventning (t-intervall, t-test, P-verdi avgrenset fra en t-tabell) eller sammenligning av to grupper (to-utvalg t, F-test for varianser, Welch, enveis variansanalyse).
42 % av deloppgavene siden 2017 er utledninger («Vis at», «Utled»), 32 % regning og 25 % tolkning («Forklar», «Kommenter»). Guiden har én seksjon per tema, ordnet etter dette skjelettet, med eksempler i eksamensform og egne data.
Estimering: moment- og ML-estimatorer
EksamensrelevantMomentestimator og maksimum likelihood-estimator utledet steg for steg, med kontroll av maksimum, forventningsretthet og invarians. Oppgavetypen står i alle ni eksamenssettene 2017–2025.
Hva eksamen spør om
Estimeringsoppgaven er fast inventar: den står i alle 9 settene 2017–2025 og i 21 av 22 sett siden 2004. Den har nesten alltid samme gang: momentestimator, så maksimum likelihood, så egenskaper ved estimatoren (og derfra videre til Fisher-informasjon, se Likelihoodteori).
- Utled MLE (sett opp likelihood og log-likelihood, deriver, løs): i 9 av 9 sett 2017–2025, sist H2025 1b. Typisk ber settet deg først sette opp likelihood og log-likelihood og så vise at MLE har en oppgitt form (H2022 2a).
- Momentestimator: i 6 av 9 sett 2017–2025, sist H2025 1a. H2024 1b ba i tillegg om å kommentere at momentmetoden ikke gir et entydig svar.
- Forventningsrett og varians til en estimator: 3 av 9 sett 2017–2025 (H2018 1a, H2023 2b, H2025 1a), som regel med «vis at» og i H2023 som «beregn forventning og varians for ML-estimatet».
- Invarians: MLE for en funksjon av parameteren (H2022 2d).
- Tall inn i estimatoren fra oppgitte summer (H2024 1e, H2025 1d). Settene gir eller , ikke rådataene.
Slik gjør du det
Momentestimator.
- Skriv opp som funksjon av parameteren (den er som regel oppgitt).
- Sett og løs for parameteren. Med to ukjente trengs også .
- Skriv svaret med store bokstaver (): det er en estimator, altså en stokastisk variabel.
Maksimum likelihood.
- , med alle ledd (H2023 2a trakk for utelatte konstanter i selve likelihooden).
- : produkt blir sum, konstanter kan nå skilles ut.
- Løs .
- Vis at det er et maksimum: , eller at skifter fra positiv til negativ.
- Bytt med når oppgaven spør etter estimatoren.
Eksempel 1 (moment og MLE, halvnormal modell). En robotarm plasserer komponenter på kretskort. La være avstanden i mm, i absoluttverdi, mellom plasseringen og målpunktet langs én akse. Vi antar at er uavhengige med tetthet for , og det er oppgitt at . Ti målinger: 2,43 1,62 0,43 0,19 0,08 1,98 0,41 1,89 0,80 0,17, med og . Finn momentestimatoren og MLE, og regn ut begge estimatene.
- Momentlikningen gir .
- Likelihood:
- Log-likelihood: .
- Derivert: gir , altså .
- Maksimum: . Med blir .
- Tall: gir , og .
Svar: og . Estimatene er mm og mm. De er ulike fordi momentestimatoren bruker , mens MLE bruker .
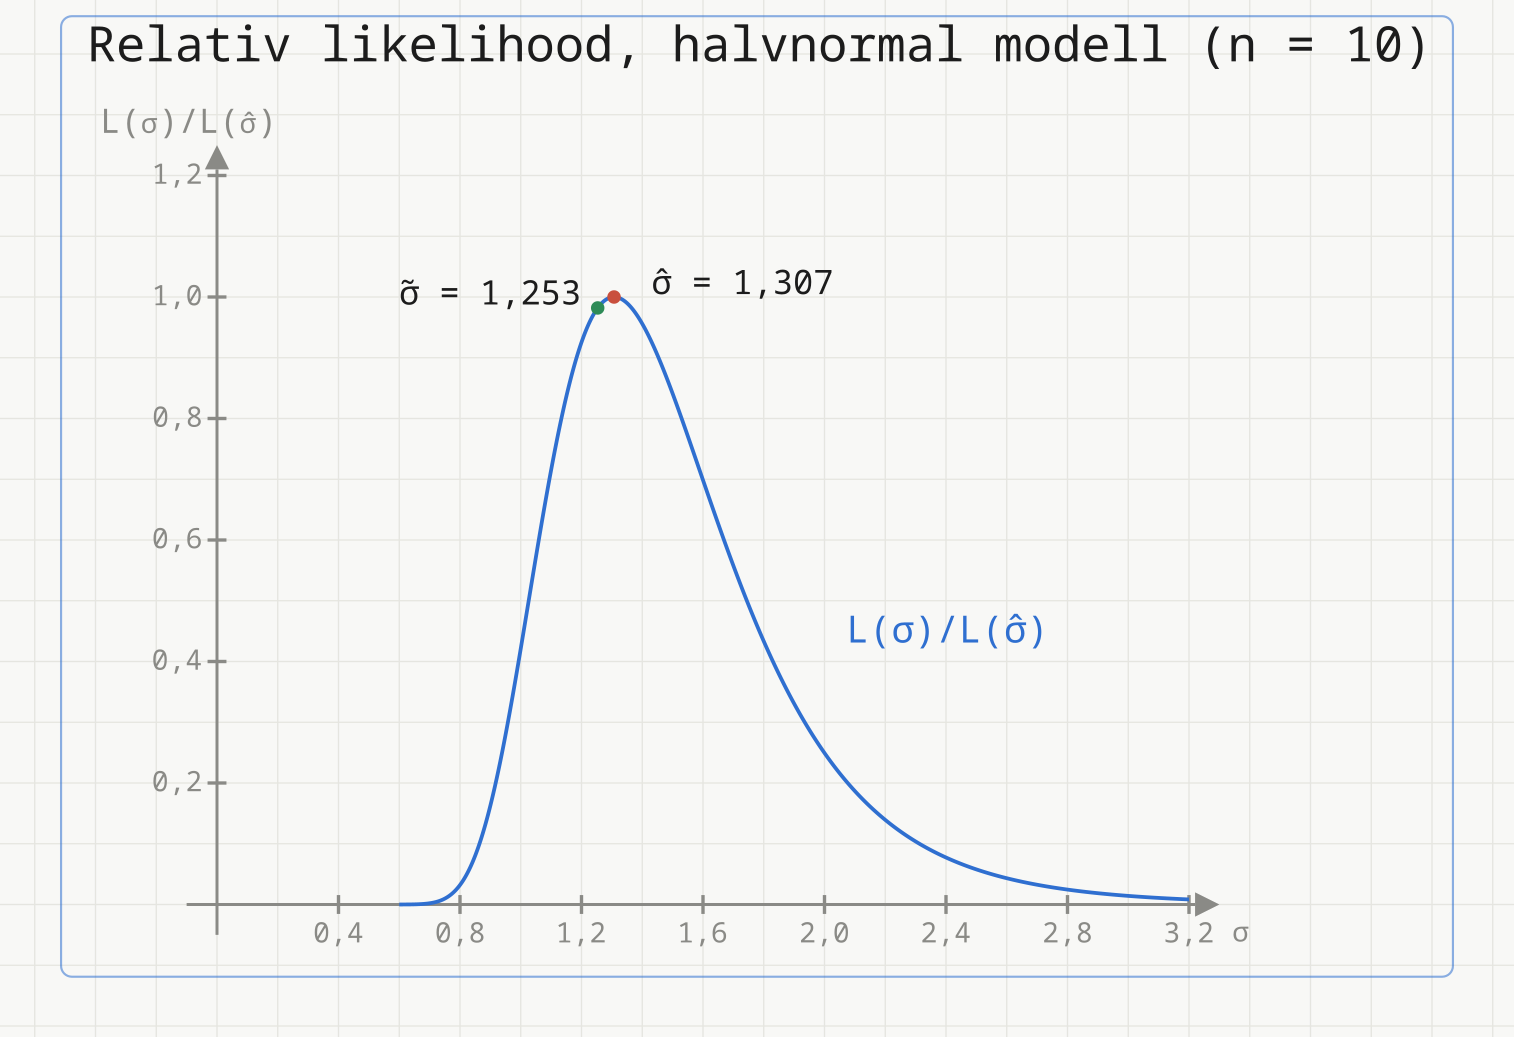
Figuren viser den relative likelihooden . Toppen (verdi 1) ligger i . Momentestimatet gir 98 % av den største likelihooden, men ikke den største.
Forventningsrett og varians. Settene spør om dette for estimatorer som er lineære i .
- (linearitet), så er forventningsrett for .
- (uavhengighet).
- En ikke-lineær funksjon er som regel ikke forventningsrett for . Er strengt konveks, gir Jensens ulikhet .
Invarians. Er MLE for , er MLE for . Du trenger ikke derivere på nytt (H2022 2d).
Eksempel 2 (moment = MLE, invarians, geometrisk modell). En kontrollør teller hvor mange feilfrie enheter som passerer før den første defekte. Tellingen gjentas 40 ganger uavhengig, og . Modell: , , med oppgitt. Finn moment- og ML-estimatoren for , og MLE for sannsynligheten for at minst 5 feilfrie enheter passerer før den første defekte.
- Moment: gir , så .
- Likelihood: , og .
- gir , altså .
- for alle , så stasjonærpunktet er globalt maksimum. Her er moment- og ML-estimatoren like.
- Tall: .
- (geometrisk rekke). Invarians gir MLE .
- Forventningsrett? er forventningsrett for , men er strengt konveks for . Da gir Jensen , så er ikke forventningsrett. Den er likevel konsistent, fordi .
Svar: , med estimat 0,235. MLE for er . er ikke forventningsrett, men den er konsistent.
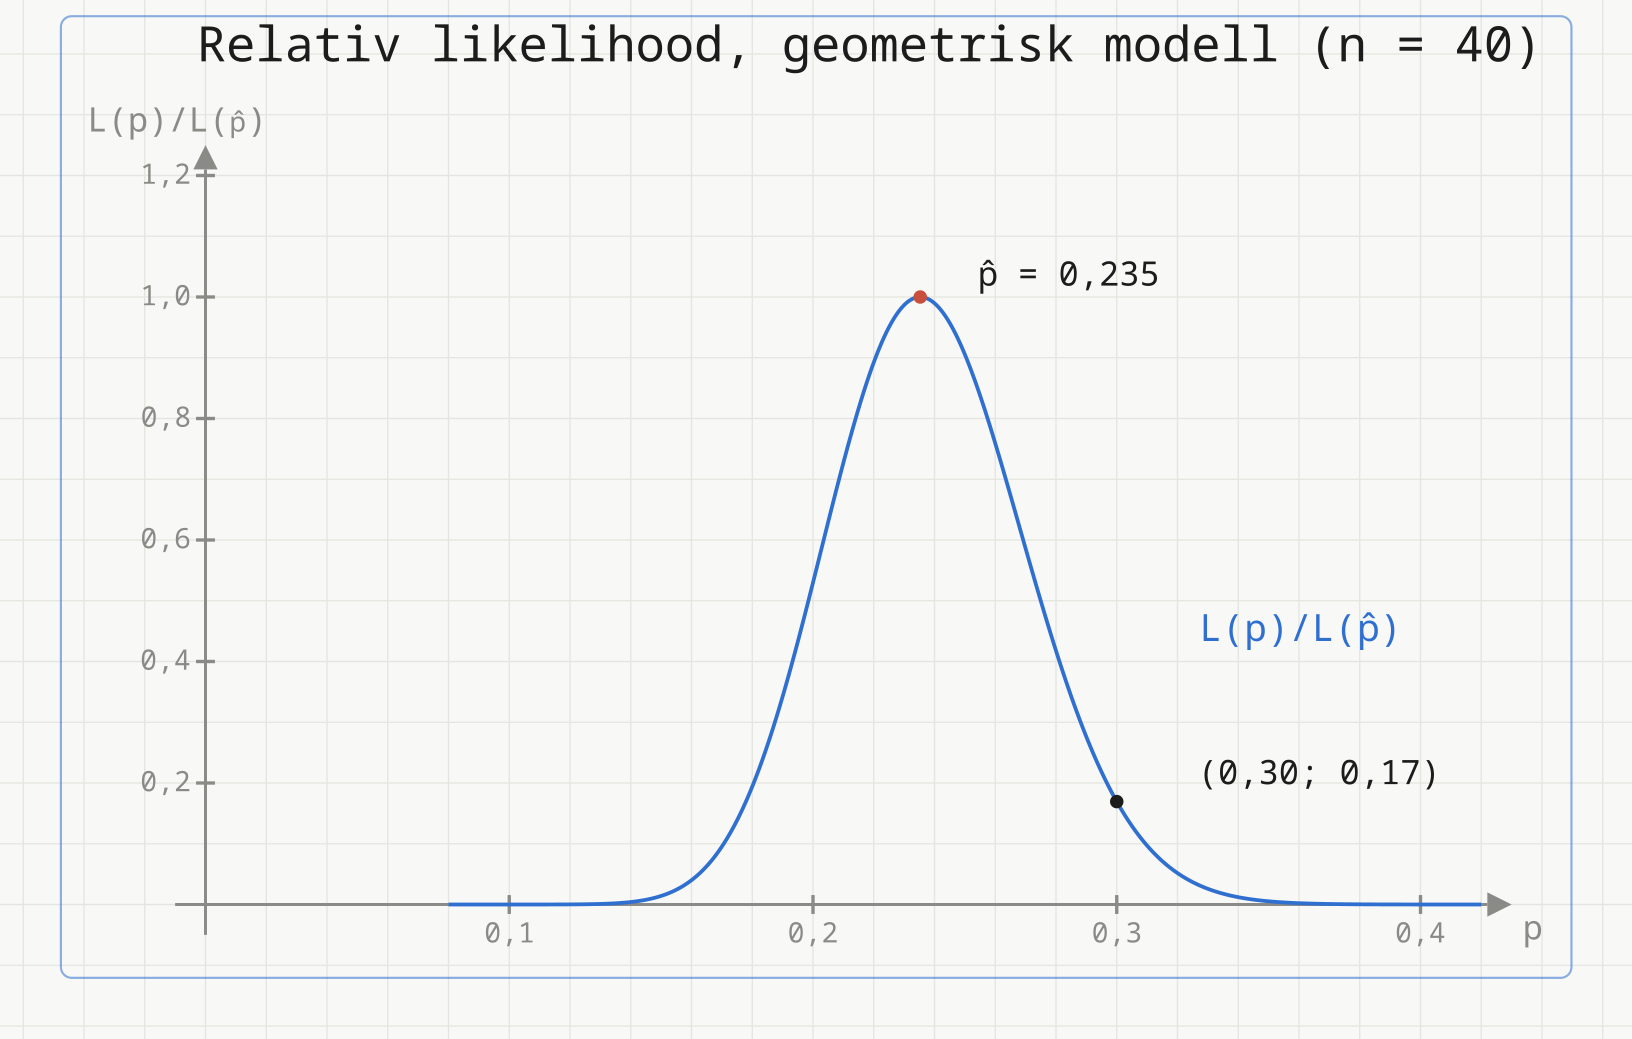
Her går det galt
- Ingen sjekk av maksimum. UiOs løsningsforslag viser eller fortegnsskifte. Et stasjonærpunkt alene er ikke et maksimum.
- Likelihood uten alle ledd. Konstanter kan droppes i når du deriverer, men ikke i selve når oppgaven ber deg sette den opp (H2023 2a).
- Estimat og estimator blandes. Spør oppgaven etter estimatoren, skal svaret stå i . Tallet du regner ut, er estimatet.
- Feil parameter. Deriverer du med hensyn på , får du . Med invarians blir , men svaret må gjelde den parameteren oppgaven spør om.
- i momentmetoden. Momentmetoden bruker empiriske momenter , ikke med .
- Tallene ikke satt inn. Når settet gir eller , skal estimatet regnes ut med de oppgitte summene. Rådataene står sjelden i oppgaven. \n
- Funksjoner av forventningsrette estimatorer. At er forventningsrett, betyr ikke at , eller er det.
Nøkkelformler
- •Momentmetoden: løs (og ev. ) for parameteren
- •,
- •MLE: og
- •Invarians: MLE for er
- •,
- •Forventningsrett: ; konsistent: i sannsynlighet
Vanlige feil
- ⚠️Løser uten å vise at løsningen er et maksimum
- ⚠️Utelater konstanter i selve likelihooden når oppgaven ber om å sette den opp
- ⚠️Bruker med i momentmetoden i stedet for
- ⚠️Tror at er forventningsrett for når er ikke-lineær
- ⚠️Skriver estimatoren med små , altså som et tall i stedet for en stokastisk variabel
Eksamenstips
- 💡Skriv , , og på hver sin linje. Det er det løsningsforslagene gir uttelling for.
- 💡Står det «vis at MLE blir …», kan du kontrollere svaret ved å sette det inn i
- 💡Uttrykk ved når du regner ut . Da forenkler uttrykket seg
- 💡Bruk invarians når oppgaven spør om MLE for en funksjon av parameteren. Du trenger ikke derivere på nytt
Laster...
Laster…